Sentinelle
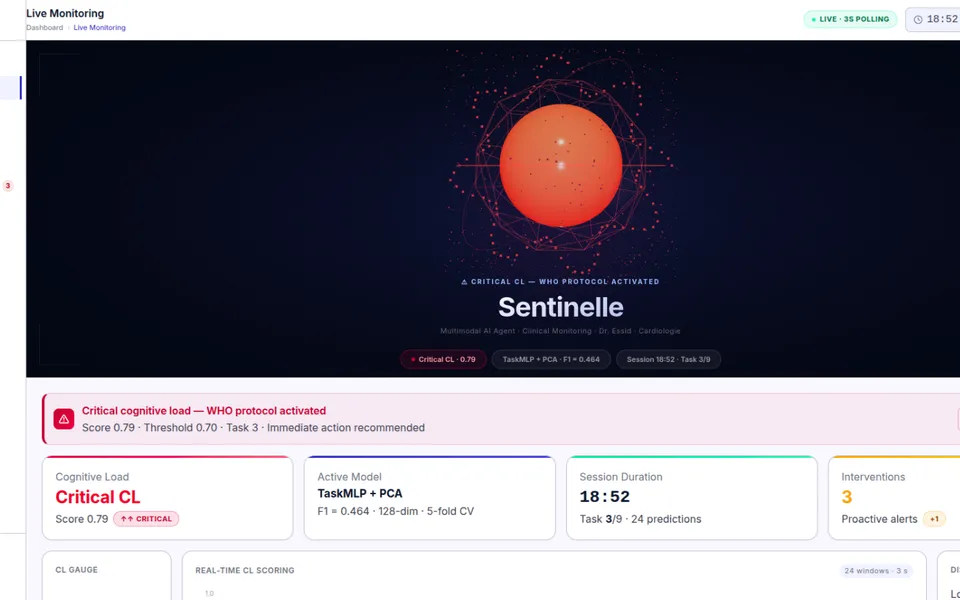
Un agent clinique qui estime la charge cognitive d'un soignant à partir de sa voix, et adapte ses recommandations à son état.
- IA multimodale
- CNN-LSTM
- RAG
- Mistral 7B
- ChromaDB
- LangChain
- TTS
Contexte
Sentinelle explore une question de recherche appliquée : peut-on estimer, en continu et sans capteur intrusif, la charge cognitive d’un professionnel de santé — et lui apporter une aide adaptée au bon moment ?
Problème
Les mesures de charge cognitive reposent souvent sur des capteurs dédiés, peu compatibles avec un usage clinique courant. Il fallait une estimation à partir de signaux légers (la voix, le visage), puis un assistant capable de changer de stratégie selon l’état détecté : on ne conseille pas la même chose à un soignant détendu et à un soignant surchargé.
Architecture
- Signaux audio et vidéo : caractéristiques acoustiques sur fenêtre glissante avec librosa (MFCC, fréquence fondamentale, énergie, jitter, débit de parole) et caractéristiques visuelles (posture, orientation de la tête) avec MediaPipe.
- Modèles de charge cognitive :
- un modèle de fusion CNN-LSTM — encodeur visuel MobileNetV2 et branche audio, réunis dans un LSTM partagé — entraîné sur RAVDESS (audio + visuel) ;
- un MLP au niveau de la tâche sur AVCAffe, jeu de données de charge cognitive, avec normalisation par participant, comparé à Random Forest, SVM et XGBoost ;
- CLSE, PoseTrack et BIWI en complément, pour valider l’audio seul, la posture et l’orientation de la tête.
- Déclenchement : l’agent ne s’active que lorsque le score de charge dépasse un seuil critique ; sinon, simple suivi sur le tableau de bord.
- Agent RAG clinique : recommandations de l’OMS découpées en extraits, vectorisées avec nomic-embed-text et stockées dans ChromaDB ; chaîne LangChain RetrievalQA avec Mistral 7B (Ollama, quantifié).
- Prompts adaptés à la charge : trois modèles de prompt — charge élevée : interventions immédiates, sécurité du patient d’abord ; moyenne : suivi et prévention ; faible : apprentissage et tâches complexes.
- Interaction vocale : la parole du soignant est transcrite avec Whisper, et la réponse sourcée est affichée sur le tableau de bord puis lue à voix haute (Piper).
- 100 % local : aucune API externe, l’index persiste et la base de connaissances se met à jour sans réentraîner le modèle.
- Infrastructure : Docker Compose — API FastAPI, Ollama, ChromaDB, MLflow pour le suivi des expériences, Redis + Celery pour les tâches longues, PostgreSQL pour les métadonnées, MongoDB pour les artefacts bruts — et CI GitHub Actions.
Stack
Python, PyTorch (MobileNetV2, LSTM, MLP), scikit-learn, XGBoost, librosa, MediaPipe, Whisper, LangChain, ChromaDB, nomic-embed-text, Mistral 7B via Ollama, Piper TTS, FastAPI, Celery, Redis, PostgreSQL, MongoDB, MLflow, Docker, React + TypeScript. Entraînement du CNN-LSTM sur GPU Kaggle.
Points clés
- Chaîne complète : de la voix et de l’image du soignant jusqu’à une recommandation clinique sourcée, lue à voix haute.
- Agent qui s’adapte : la même base de connaissances, mais trois stratégies de réponse selon l’état cognitif détecté.
- Démarche de recherche : plusieurs familles de modèles comparées, validation croisée par participant pour éviter que le modèle ne reconnaisse simplement la personne, et évaluation de l’agent RAG avec RAGAS.
- Confidentialité par conception : tout tourne en local, aucune donnée ne sort de la machine.
- Backend FastAPI et tableau de bord React en cours.