Chatbot RAG Marketing
Un assistant qui répond aux questions de stratégie marketing à partir d'un corpus de cours — et dit clairement quand il ne sait pas.
- RAG
- LangChain
- FAISS
- Llama 3.3
- HuggingFace
- Gradio
Contexte
Étudiants et professionnels du marketing passent beaucoup de temps à fouiller cours, guides et documents de stratégie pour répondre à des questions précises — « comment segmenter un marché ? », « qu’est-ce que le marketing mix ? ». Les réponses existent, mais elles sont dispersées entre plusieurs sources.
Problème
Il fallait un outil capable de répondre directement à une question de stratégie marketing, avec une réponse ancrée dans un corpus de référence plutôt qu’un texte générique — et qui reconnaît ses limites quand l’information n’est pas dans les documents.
Architecture
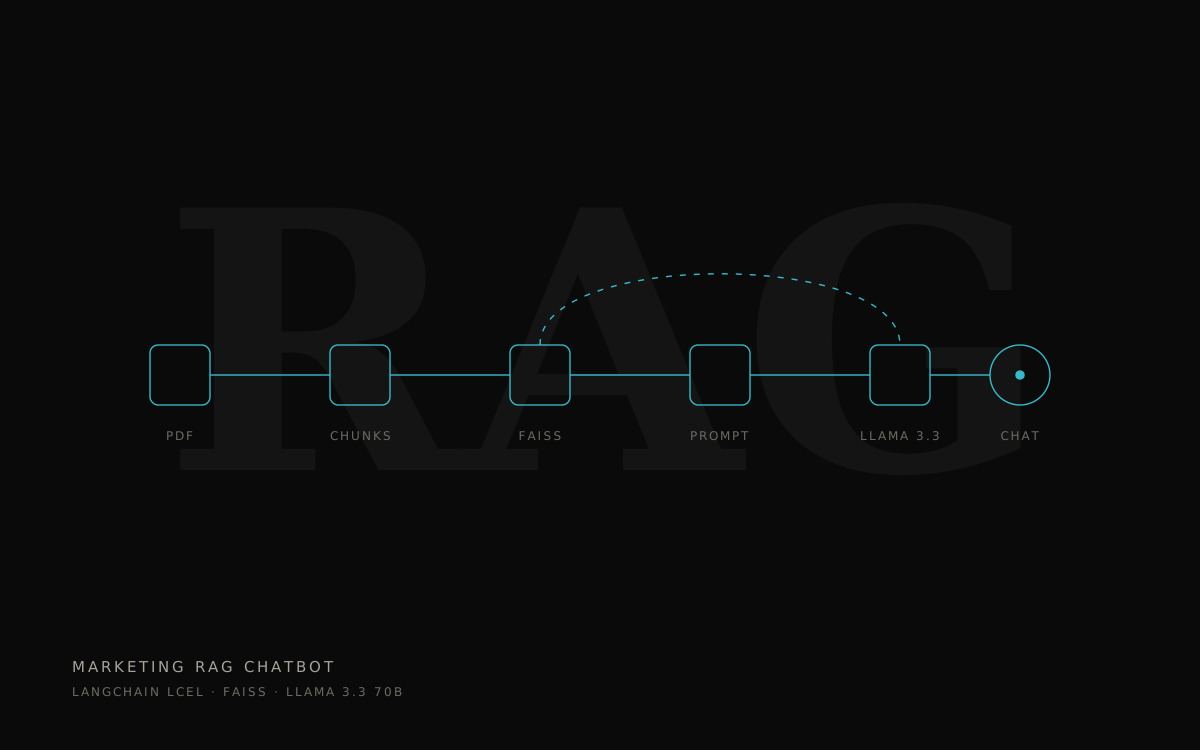
Un pipeline RAG en quatre étapes, construit dans Google Colab :
- Ingestion : extraction du texte d’un dossier de cours de marketing en PDF (PyMuPDF), avec détection des PDF scannés sans texte, puis découpage en extraits de 600 caractères (recouvrement de 50).
- Indexation : embeddings
all-MiniLM-L6-v2(sentence-transformers) et index FAISS sauvegardé sur Google Drive — il est rechargé aux exécutions suivantes au lieu d’être recalculé. - Recherche : les 5 extraits les plus proches de la question sont récupérés.
- Génération : une chaîne LangChain (
create_retrieval_chain) passe ces extraits à Llama 3.3 70B Instruct via l’API d’inférence HuggingFace, avec un prompt qui impose de répondre uniquement à partir du contexte et de le dire clairement sinon.
L’interface Gradio propose un champ de question, des exemples préchargés et un lien public partageable.
Évolution
Une première version reposait sur ChromaDB et un Llama 2 7B quantifié exécuté localement (llama.cpp). La version finale passe à FAISS persistant et à Llama 3.3 70B via HuggingFace : réponses nettement meilleures, sans dépendre de la mémoire de la machine Colab.
Stack
Python, LangChain, PyMuPDF, sentence-transformers (all-MiniLM-L6-v2), FAISS, Llama 3.3 70B Instruct via HuggingFace Inference API, Gradio, Google Colab, Google Drive.
Pistes d’amélioration
- Afficher les extraits sources sous chaque réponse.
- Évaluation automatique avec RAGAs (fidélité, précision du contexte), à la place de la vérification manuelle.
- Base vectorielle serveur (ChromaDB ou Supabase pgvector) pour un usage en production.